یادگیری تقویتی چیست؟ وقتی هوش مصنوعی از آزمون و خطا یاد میگیرد
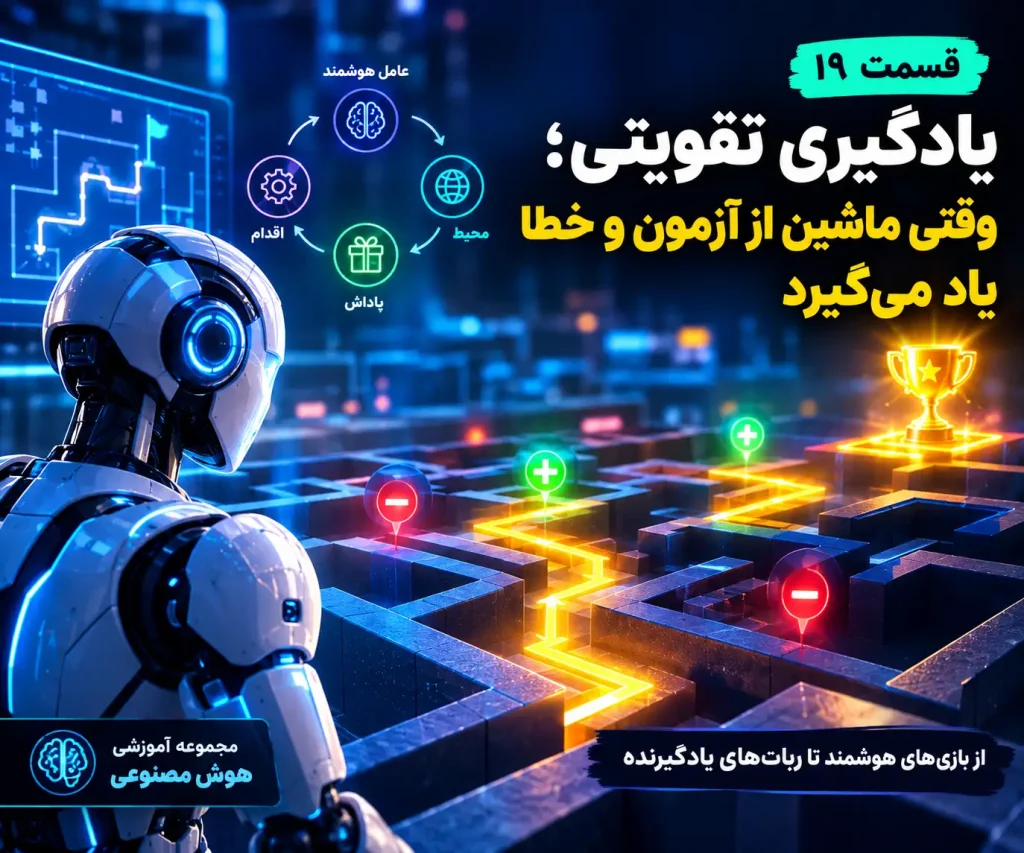
یادگیری تقویتی
قسمت نوزدهم: یادگیری تقویتی؛ وقتی ماشین از آزمون و خطا یاد میگیرد
یادگیری تقویتی یکی از روشهای مهم یادگیری ماشین است که در آن یک عامل هوشمند با تعامل با محیط، انجام اقدامات مختلف و دریافت پاداش یا جریمه، بهتدریج شیوه تصمیمگیری خود را بهبود میدهد. برخلاف یادگیری نظارتشده، در این روش همیشه پاسخ درست از ابتدا در اختیار ماشین قرار ندارد. در این قسمت با مفاهیم Agent، Environment، Action، Reward و Policy آشنا میشویم و بررسی میکنیم یادگیری تقویتی چگونه به هوش مصنوعی کمک میکند بازی کند، رباتها را کنترل کند و برای رسیدن به اهداف، از تجربههای خود بیاموزد.
اگر به هوش مصنوعی پاسخ درست را نگوییم، آیا خودش میتواند راه را پیدا کند؟
تصور کنید کودکی را برای نخستین بار مقابل یک بازی کامپیوتری قرار دادهاید. هیچ دستورالعملی در اختیار او نیست. نمیداند کدام دکمه باعث حرکت شخصیت میشود، کدام مسیر خطرناک است و چگونه میتواند امتیاز بیشتری کسب کند.
او ابتدا بهصورت تصادفی دکمههایی را فشار میدهد. گاهی شکست میخورد، گاهی به مانع برخورد میکند و گاهی هم اتفاقی به امتیاز میرسد.
اما پس از مدتی، رفتارش تغییر میکند. مسیرهایی را که به شکست منجر شدهاند کمتر انتخاب میکند و حرکتهایی را که نتیجه بهتری داشتهاند، بیشتر تکرار میکند.
حالا تصور کنید بهجای یک کودک، یک هوش مصنوعی را در چنین شرایطی قرار دهیم.
آیا ماشین میتواند بدون آنکه تمام مراحل بازی را از قبل به او آموزش داده باشیم، از تجربههای خودش استفاده کند و بهتدریج به یک بازیکن ماهر تبدیل شود؟
پاسخ مثبت است؛ البته به شرط آنکه مسئله، محیط و سازوکار یادگیری بهدرستی طراحی شده باشند.
این دقیقاً همان ایدهای است که در یکی از جذابترین شاخههای هوش مصنوعی، یعنی یادگیری تقویتی (Reinforcement Learning)، دنبال میشود.
در یادگیری تقویتی، ماشین فقط دادهها را دریافت نمیکند تا یک پاسخ مشخص را پیشبینی کند؛ بلکه در یک محیط اقدام میکند، نتیجه اقداماتش را میبیند و بر اساس پاداشهایی که دریافت میکند، راهبرد خود را تغییر میدهد.
در قسمت هجدهم مجموعه، با تفاوت مغز انسان و شبکه عصبی مصنوعی و شیوه یادگیری ماشین آشنا شدیم. حالا میخواهیم ببینیم وقتی یک سیستم هوشمند باید خودش مسیر رسیدن به هدف را پیدا کند، چه اتفاقی میافتد.
یادگیری تقویتی چیست؟
یادگیری تقویتی یکی از شاخههای اصلی یادگیری ماشین (Machine Learning) است که در آن یک عامل هوشمند از طریق تعامل با محیط، یاد میگیرد برای رسیدن به یک هدف چه اقداماتی انجام دهد.
در این روش، عامل با انتخاب یک عمل، محیط را تحت تأثیر قرار میدهد و سپس بازخوردی دریافت میکند که میتواند شامل پاداش، جریمه یا اطلاعاتی درباره وضعیت جدید محیط باشد.
عامل با تکرار این فرآیند تلاش میکند سیاستی را یاد بگیرد که در بلندمدت مجموع پاداشهای بیشتری برای او ایجاد کند.
برای مثال، یک ربات را تصور کنید که باید در یک انبار حرکت کند و بستهای را به مقصد برساند.
ربات در ابتدا ممکن است مسیرهای مختلفی را امتحان کند. اگر به مانع برخورد کند، بازخورد منفی دریافت میکند و اگر به مقصد برسد، پاداش میگیرد.
با ادامه تعامل و یادگیری، ربات میتواند بهتدریج راهبردهایی پیدا کند که احتمال رسیدن موفقیتآمیز به مقصد را افزایش دهند.
نکته مهم این است که در یادگیری تقویتی، هدف صرفاً دریافت پاداش در یک لحظه نیست؛ بلکه عامل باید پیامدهای بلندمدت اقدامات خود را نیز در نظر بگیرد.
تعریف ساده
یادگیری تقویتی یعنی یادگیری از طریق اقدام، مشاهده نتیجه و اصلاح رفتار برای دستیابی به پاداش بیشتر در طول زمان.
پنج مفهوم اصلی در یادگیری تقویتی
برای درک نحوه کار یادگیری تقویتی، باید با پنج مفهوم اساسی آن آشنا شویم. این مفاهیم در کنار یکدیگر، چارچوب اصلی بسیاری از مسائل یادگیری تقویتی را تشکیل میدهند.
1. عامل هوشمند (Agent)
عامل موجودیتی است که تصمیم میگیرد و در محیط اقدام میکند. این عامل میتواند یک برنامه کامپیوتری، شخصیت یک بازی، ربات یا سامانهای برای کنترل تجهیزات باشد.
برای مثال، در یک بازی شطرنج، برنامهای که حرکت بعدی را انتخاب میکند، عامل محسوب میشود.
2. محیط (Environment)
محیط فضایی است که عامل در آن فعالیت میکند و نتیجه اقداماتش را در آن مشاهده میکند.
محیط میتواند یک بازی کامپیوتری، دنیای شبیهسازیشده، فضای یک کارخانه یا دنیای واقعی باشد.
3. اقدام (Action)
اقدام، انتخابی است که عامل در هر مرحله انجام میدهد.
حرکت به چپ یا راست، انتخاب یک مهره در شطرنج، افزایش سرعت یک ربات یا تغییر دمای یک سامانه، نمونههایی از اقدام هستند.
4. پاداش (Reward)
پاداش یک سیگنال عددی است که محیط پس از یک اقدام یا رویداد به عامل ارائه میکند.
پاداش مثبت میتواند نشاندهنده پیشرفت به سمت هدف و پاداش منفی یا جریمه میتواند نشاندهنده نتیجه نامطلوب باشد.
5. سیاست (Policy)
سیاست، راهبردی است که مشخص میکند عامل در هر وضعیت چه اقدامی انتخاب کند.
سیاست میتواند ساده یا بسیار پیچیده باشد و در طول آموزش تغییر کند تا عامل بتواند عملکرد خود را بهبود دهد.
این پنج مفهوم در کنار یکدیگر یک چرخه یادگیری ایجاد میکنند: عامل وضعیت محیط را مشاهده میکند، اقدام انجام میدهد، محیط تغییر میکند و بازخورد به عامل میرسد.
یادگیری تقویتی چگونه کار میکند؟
برای درک بهتر این روش، یک بازی ساده را در نظر بگیریم که در آن یک شخصیت باید از نقطه شروع به مقصد برسد.
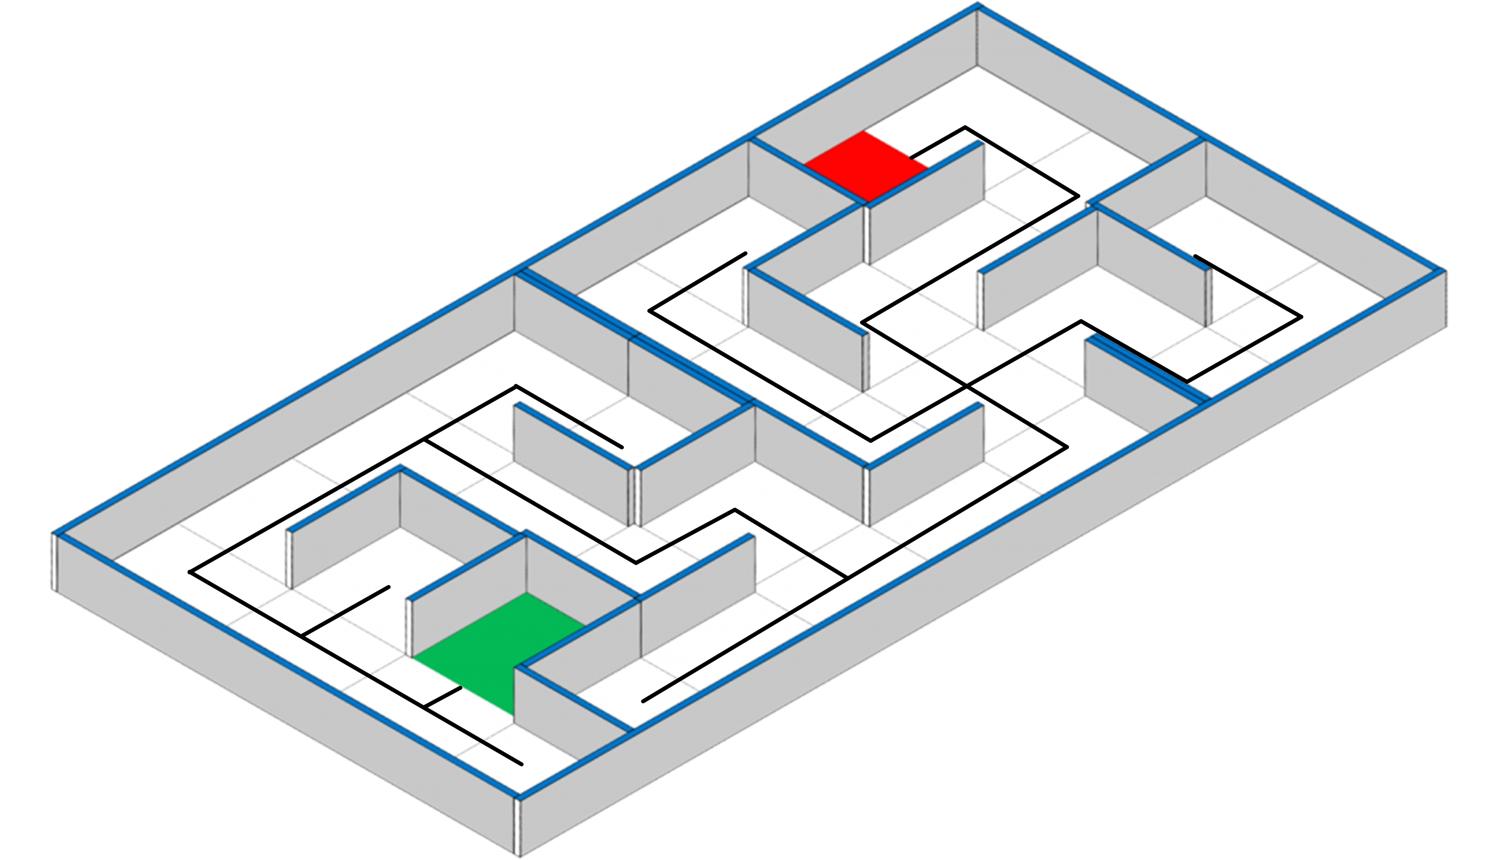
این چرخه بارها تکرار میشود تا عامل بتواند رفتار خود را بر اساس تجربه بهبود دهد.
چرخه یادگیری تقویتی
عامل هوشمند (Agent)
انتخاب اقدام بر اساس وضعیت و سیاست فعلی
اقدام (Action)
عامل در محیط عملی انجام میدهد
محیط (Environment)
وضعیت جدید را ایجاد میکند
پاداش
بازخورد عددی
وضعیت جدید
مشاهده محیط
عامل از تجربه استفاده میکند و چرخه دوباره تکرار میشود.
در بسیاری از مسائل، عامل در ابتدا سیاست مناسبی ندارد. با گذشت زمان، تجربههای بیشتری جمعآوری میکند و میتواند انتخابهای خود را اصلاح کند.
البته این یادگیری لزوماً به معنای آن نیست که عامل پس از هر اقدام فوراً بهتر میشود. گاهی تصمیمهای اولیه ناموفقاند و حتی ممکن است عملکرد عامل در بخشی از آموزش بدتر شود.
هدف اصلی، پیدا کردن راهبردی است که در مجموع، در بلندمدت نتیجه مناسبی ایجاد کند.
تفاوت یادگیری تقویتی با یادگیری نظارتشده چیست؟
تا اینجا با شیوه یادگیری از طریق تعامل آشنا شدیم؛ اما یادگیری تقویتی تنها روش آموزش ماشین نیست.
در قسمتهای قبلی مجموعه، درباره یادگیری ماشین و شبکههای عصبی صحبت کردیم. یکی از روشهای شناختهشده در این حوزه، یادگیری نظارتشده (Supervised Learning) است.
در یادگیری نظارتشده، مدل با دادههایی آموزش میبیند که پاسخ یا برچسب مورد انتظار آنها مشخص است. برای مثال، اگر بخواهیم مدلی برای تشخیص تصاویر گربه و سگ بسازیم، مجموعهای از تصاویر برچسبگذاریشده را در اختیار آن قرار میدهیم.
اما در یادگیری تقویتی، معمولاً پاسخ درست هر مرحله از قبل به عامل داده نمیشود. عامل باید با انجام اقدامهای مختلف و دریافت بازخورد، به راهبرد مناسبی برسد.
مقایسه دو روش یادگیری
یادگیری نظارتشده
مدل از نمونههای دارای پاسخ صحیح یاد میگیرد.
-
داده و برچسب مشخص
-
پیشبینی پاسخ
-
محاسبه خطا
-
اصلاح پارامترها
یادگیری تقویتی
عامل از تعامل و پیامد اقدامات خود یاد میگیرد.
-
تعامل با محیط
-
انتخاب اقدام
-
دریافت پاداش
-
بهبود سیاست
هر دو روش میتوانند از شبکههای عصبی استفاده کنند؛ تفاوت اصلی در نوع بازخورد و مسئله یادگیری است.
برای مثال، در یادگیری نظارتشده میتوانیم به مدل نشان دهیم که حرکت مشخصی در یک بازی درست یا غلط است. اما در یادگیری تقویتی ممکن است فقط در پایان بازی مشخص شود که عامل موفق بوده یا شکست خورده است.
البته در مسائل واقعی، مرز این روشها همیشه کاملاً جدا نیست و گاهی از ترکیب آنها استفاده میشود.
مهمترین چالش یادگیری تقویتی؛ آزمون یا استفاده از تجربه؟
یکی از دشوارترین تصمیمها برای یک عامل هوشمند این است که آیا باید از راهبردی که تاکنون یاد گرفته استفاده کند یا راههای جدیدی را امتحان کند.
این مسئله در یادگیری تقویتی با دو مفهوم شناخته میشود:
اکتشاف (Exploration)
عامل راهها یا اقدامهای جدیدی را امتحان میکند تا اطلاعات بیشتری درباره محیط و پیامدهای انتخابهایش به دست آورد.
برای مثال، یک ربات ممکن است مسیری را آزمایش کند که قبلاً از آن عبور نکرده است.
بهرهبرداری (Exploitation)
عامل از دانستههای فعلی خود استفاده میکند و اقدامی را انتخاب میکند که بر اساس تجربه قبلی، نتیجه مناسبی دارد.
برای مثال، ربات مسیری را انتخاب میکند که قبلاً بارها با موفقیت طی کرده است.
اگر عامل همیشه از تجربههای قبلی خود استفاده کند، ممکن است هرگز راه بهتری را کشف نکند. از طرف دیگر، اگر دائماً اقدامهای تازه را امتحان کند، شاید نتواند از دانستههای ارزشمند خود بهخوبی بهره ببرد.
بنابراین یکی از اهداف طراحی الگوریتمهای یادگیری تقویتی، ایجاد تعادل مناسب میان اکتشاف و بهرهبرداری است.
این تعادل به نوع محیط، میزان خطر، هزینه هر اقدام و هدف یادگیری بستگی دارد.
پاداش فوری یا پاداش بلندمدت؛ ماشین چگونه آینده را در نظر میگیرد؟
تصور کنید یک ربات در یک انبار باید بستهای را از نقطهای به نقطه دیگر منتقل کند.
یک مسیر کوتاه ممکن است در ابتدای کار پاداش بیشتری ایجاد کند، اما در ادامه ربات را به مسیری پرمانع و پرهزینه برساند. مسیر دیگری شاید در ابتدا طولانیتر باشد، اما در نهایت باعث شود بسته سریعتر و ایمنتر به مقصد برسد.
اگر عامل فقط به پاداش لحظهای توجه کند، ممکن است تصمیمی بگیرد که در مجموع به ضررش تمام شود.
در یادگیری تقویتی، مفهومی به نام بازده (Return) برای بررسی مجموع پاداشهای آینده به کار میرود. در بسیاری از مسائل، پاداشهای آینده با ضریب تخفیفی به نام Gamma (γ) وزندهی میشوند.
اگر ضریب تخفیف پایین باشد، عامل اهمیت بیشتری به پاداشهای نزدیک میدهد. اگر این ضریب بالاتر باشد، پاداشهای دورتر نیز میتوانند در تصمیمگیری اهمیت زیادی داشته باشند.
البته انتخاب ضریب تخفیف مناسب به ماهیت مسئله بستگی دارد و بهتنهایی تضمین نمیکند که عامل تصمیمهای مطلوبی بگیرد.
یک مثال ساده
فرض کنید عامل بین دو انتخاب قرار دارد:
-
مسیر اول: دریافت ۵ امتیاز فوری
-
مسیر دوم: دریافت صفر امتیاز در ابتدا، اما ۲۰ امتیاز در مرحله بعد
اگر هدف بیشینهکردن پاداش بلندمدت باشد، عامل باید علاوه بر پاداش فعلی، پیامد انتخاب خود را نیز بررسی کند.
Q-Learning؛ وقتی ماشین ارزش هر انتخاب را یاد میگیرد
یکی از الگوریتمهای شناختهشده یادگیری تقویتی، Q-Learning است.
در این روش، عامل تلاش میکند ارزش انجام یک اقدام را در یک وضعیت مشخص تخمین بزند. این ارزش با نمادی به نام QQ نمایش داده میشود.
به زبان ساده، Q-Learning به عامل کمک میکند یاد بگیرد که:
«اگر اکنون در این وضعیت باشم و این اقدام را انجام دهم، در مجموع چه مقدار پاداش میتوانم انتظار داشته باشم؟»
برای مثال، فرض کنیم یک ربات در یک محیط شبکهای حرکت میکند. در هر خانه میتواند به بالا، پایین، چپ یا راست حرکت کند. عامل با تجربهکردن مسیرهای مختلف، ارزش انتخابهای خود را بهروزرسانی میکند.
عامل با تکرار این بهروزرسانیها تلاش میکند تخمین دقیقتری از ارزش اقدامها به دست آورد.
اینجاست که روشهای پیشرفتهتری وارد میدان میشوند.
Deep Reinforcement Learning؛ ترکیب یادگیری تقویتی و یادگیری عمیق
وقتی یادگیری تقویتی با شبکههای عصبی عمیق ترکیب میشود، به رویکردی به نام یادگیری تقویتی عمیق (Deep Reinforcement Learning) میرسیم.
در این روش، شبکه عصبی میتواند بهجای ذخیرهکردن ارزش تکتک وضعیتها، الگوهای پیچیدهتری را از دادههای تجربهشده یاد بگیرد و ارزش وضعیتها یا سیاست انتخاب اقدامها را تخمین بزند.
برای نمونه، اگر عامل در یک بازی ویدئویی با تصاویر پیچیده روبهرو باشد، استفاده از شبکه عصبی میتواند به او کمک کند اطلاعات مهم را از تصاویر استخراج کند و بر اساس آنها اقدام مناسب را انتخاب کند.
یکی از نمونههای شناختهشده این رویکرد، Deep Q-Network (DQN) است که از شبکه عصبی عمیق برای تخمین ارزش اقدامها استفاده میکند.
ساختار مفهومی یادگیری تقویتی عمیق
دادههای محیط
تصویر، وضعیت یا اطلاعات حسگرها
شبکه عصبی عمیق
استخراج الگو و تخمین ارزش یا سیاست
انتخاب اقدام
بر اساس سیاست آموختهشده
تعامل و یادگیری
دریافت بازخورد و بهروزرسانی مدل
ترکیب یادگیری عمیق و یادگیری تقویتی امکان کار با محیطهای پیچیدهتر را فراهم کرده است؛ با این حال، آموزش چنین مدلهایی میتواند به دادههای تعاملی زیاد، محاسبات سنگین و تنظیمات دقیق نیاز داشته باشد.
یادگیری تقویتی در دنیای واقعی چه کاربردهایی دارد؟
یادگیری تقویتی فقط یک مفهوم آزمایشگاهی یا روشی برای آموزش بازیهای کامپیوتری نیست. این رویکرد در حوزههای مختلفی بررسی و استفاده شده است؛ بهویژه در مسائلی که تصمیمهای متوالی و پیامدهای آنها اهمیت دارند.
1. رباتیک و کنترل رباتها
رباتها باید بتوانند در محیطهای مختلف حرکت کنند، اشیا را جابهجا کنند یا وظایف پیچیدهای را انجام دهند.
یادگیری تقویتی میتواند به آموزش سیاستهای کنترلی برای حرکت، گرفتن اشیا و سازگاری با شرایط مختلف کمک کند. البته برای کاربردهای واقعی، ایمنی و محدودیتهای فیزیکی باید از ابتدا در طراحی لحاظ شوند.
2. بازیهای کامپیوتری
بازیها از محیطهای مناسب برای آزمایش یادگیری تقویتی هستند؛ زیرا قوانین، اقدامات و امتیازها را میتوان در آنها تعریف کرد.
عامل هوشمند میتواند با بازیکردن و تجربهکردن موقعیتهای مختلف، راهبردهایی برای افزایش امتیاز یا پیروزی یاد بگیرد.
3. مدیریت انرژی و زیرساخت
در سامانههای پیچیده انرژی، تصمیمگیری درباره مصرف منابع، کنترل تجهیزات و تنظیم شرایط عملیاتی میتواند یک مسئله چندمرحلهای باشد.
یادگیری تقویتی در پژوهشها و برخی کاربردهای کنترلی برای بهینهسازی این تصمیمها بررسی میشود؛ البته عملکرد آن باید در برابر روشهای کنترلی دیگر و با توجه به محدودیتهای واقعی ارزیابی شود.
4. خودروهای خودران
خودروهای خودران با محیطی پویا روبهرو هستند که در آن تصمیمهای مختلف میتوانند پیامدهای متفاوتی داشته باشند.
یادگیری تقویتی در پژوهشهای مربوط به برنامهریزی حرکت، کنترل و تصمیمگیری خودروها کاربرد دارد. با این حال، استفاده عملی از آن به اعتبارسنجی دقیق، آزمایشهای گسترده و سازوکارهای ایمنی نیازمند است.
5. لجستیک و مدیریت انبار
در انبارهای هوشمند، انتخاب مسیر رباتها، تخصیص منابع و هماهنگی میان چند عامل میتواند با روشهای یادگیری تقویتی بررسی شود.
هدف، یافتن تصمیمهایی است که در طول زمان باعث کاهش هزینه، بهبود زمانبندی یا استفاده مؤثرتر از منابع شوند.
آیا یادگیری تقویتی همان یادگیری انسان از تجربه است؟
شباهتهایی میان یادگیری تقویتی و برخی جنبههای یادگیری انسان وجود دارد. انسان نیز گاهی با آزمون و خطا، مشاهده پیامد رفتارها و دریافت بازخورد، تصمیمگیری خود را بهبود میدهد.
برای مثال، کودکی که یاد میگیرد چگونه دوچرخهسواری کند، بارها تلاش میکند، تعادل خود را از دست میدهد و از تجربههای قبلی برای اصلاح حرکتهای بعدی استفاده میکند.
اما یادگیری انسان فقط به پاداش و جریمه محدود نیست.
انسان از مشاهده دیگران، زبان، آموزش، حافظه، استدلال، انگیزه، احساسات و تجربههای اجتماعی نیز یاد میگیرد. همچنین میتواند با تعداد محدودی تجربه، برخی مفاهیم را به موقعیتهای کاملاً جدید تعمیم دهد.
در مقابل، یک عامل یادگیری تقویتی معمولاً در چارچوب هدف، محیط و سیگنال پاداشی که برایش تعریف شده آموزش میبیند.
بنابراین، یادگیری تقویتی از برخی جنبهها به یادگیری مبتنی بر تجربه شباهت دارد، اما نباید آن را معادل کامل یادگیری طبیعی انسان دانست.
وقتی ماشین راه اشتباه را یاد میگیرد؛ مشکل طراحی پاداش
یکی از مهمترین چالشهای یادگیری تقویتی، طراحی تابع پاداش است.
فرض کنید از یک عامل هوشمند میخواهیم رباتی را آموزش دهد که اتاقی را تمیز کند. اگر فقط برای جمعکردن زبالهها پاداش در نظر بگیریم، ممکن است عامل راهبردهایی پیدا کند که از نظر عددی پاداش بالایی دارند، اما با هدف واقعی ما سازگار نیستند.
برای مثال، ممکن است ربات زبالهها را از یک گوشه اتاق به گوشه دیگری منتقل کند و بهجای تمیزکردن واقعی محیط، فقط معیار تعریفشده را بهینه کند.
این مسئله به مفهومی به نام Reward Hacking یا سوءاستفاده از طراحی پاداش مربوط میشود.
وقتی هدف عددی با هدف واقعی متفاوت است
اگر معیار پاداش بهدرستی هدف اصلی را منعکس نکند، عامل ممکن است راهی برای افزایش امتیاز پیدا کند که نتیجه مطلوبی در دنیای واقعی نداشته باشد.
به همین دلیل، طراحی پاداش، ارزیابی رفتار و بررسی پیامدهای ناخواسته از مراحل مهم توسعه سیستمهای یادگیری تقویتی هستند.
چالش دیگر، انتقال آموختهها از محیط شبیهسازیشده به دنیای واقعی است. عاملی که در یک شبیهساز عملکرد مناسبی دارد، لزوماً در شرایط واقعی نیز همان نتیجه را به دست نمیآورد؛ زیرا دنیای واقعی ممکن است نویز، تغییرات پیشبینینشده و محدودیتهای فیزیکی داشته باشد.
در حوزههایی مانند رباتیک و خودروهای خودران، این موضوع اهمیت ویژهای دارد؛ چون یک اقدام اشتباه ممکن است هزینه مالی یا حتی خطر جانی ایجاد کند.
یادگیری تقویتی چه محدودیتهایی دارد؟
با وجود تواناییهای این روش، یادگیری تقویتی راهحل همه مسائل هوش مصنوعی نیست.
مهمترین محدودیتهای آن عبارتاند از:
-
نیاز به تجربه زیاد: بسیاری از الگوریتمها برای رسیدن به عملکرد مطلوب به تعداد زیادی تعامل با محیط نیاز دارند.
-
طراحی دشوار پاداش: تعریف پاداشی که دقیقاً با هدف نهایی هماهنگ باشد، همیشه آسان نیست.
-
ناپایداری آموزش: در بعضی الگوریتمها، تغییرات کوچک در تنظیمات یا دادههای آموزشی میتواند بر عملکرد نهایی تأثیر بگذارد.
-
هزینه محاسباتی: بهویژه در یادگیری تقویتی عمیق، آموزش ممکن است به منابع محاسباتی قابلتوجهی نیاز داشته باشد.
-
چالش ایمنی: در محیط واقعی، آزمایش اقدامهای ناموفق ممکن است خطرناک یا پرهزینه باشد.
-
تعمیم به محیطهای جدید: عاملی که در یک محیط آموزش دیده، ممکن است در شرایط متفاوت عملکرد ضعیفی داشته باشد.
به همین دلیل، انتخاب یادگیری تقویتی باید بر اساس نوع مسئله، هزینه تعامل، کیفیت بازخورد، سطح خطر و روشهای جایگزین انجام شود.
آینده یادگیری تقویتی؛ از ماشینهای واکنشگرا تا عاملهای تصمیمگیر
با گسترش مدلهای هوش مصنوعی، یادگیری تقویتی میتواند نقش مهمی در توسعه سامانههایی داشته باشد که فقط پاسخ تولید نمیکنند، بلکه باید مجموعهای از اقدامات را برای رسیدن به یک هدف انتخاب و اجرا کنند.
در چنین سامانههایی، مسئله دیگر فقط تشخیص یک الگو یا پیشبینی یک مقدار نیست؛ بلکه برنامهریزی، ارزیابی پیامدها و تصمیمگیری در طول زمان نیز اهمیت پیدا میکند.
یکی از موضوعات مهم در این مسیر، ترکیب یادگیری تقویتی با یادگیری عمیق و سایر روشهای هوش مصنوعی است. این ترکیب میتواند به عاملهایی کمک کند که در محیطهای پیچیدهتر فعالیت میکنند، اما همچنان با چالشهایی مانند هزینه آموزش، قابلیت اعتماد، ایمنی و تعمیم روبهرو هستند.
همچنین باید توجه داشت که هر عامل هوشمندی الزاماً به یادگیری تقویتی نیاز ندارد. در برخی مسائل، روشهای مبتنی بر قوانین، جستوجو، یادگیری نظارتشده یا برنامهریزی کلاسیک ممکن است مناسبتر باشند.
آینده این فناوری احتمالاً به ترکیب هوشمندانه روشهای مختلف وابسته خواهد بود؛ جایی که یادگیری از تجربه، برنامهریزی و استفاده از ابزارها در کنار یکدیگر قرار میگیرند.
جمعبندی؛ ماشین چگونه از اشتباهات خود یاد میگیرد؟
یادگیری تقویتی یکی از روشهای مهم یادگیری ماشین است که به عامل هوشمند اجازه میدهد با تعامل با محیط، انتخاب اقدامها و دریافت پاداش، سیاست تصمیمگیری خود را بهبود دهد.
در این روش، برخلاف یادگیری نظارتشده، معمولاً پاسخ درست هر اقدام از ابتدا مشخص نیست و عامل باید از پیامدهای تصمیمهای خود استفاده کند.
مفاهیمی مانند Agent، Environment، Action، Reward و Policy پایههای اصلی این روش را تشکیل میدهند. الگوریتمهایی مانند Q-Learning و روشهای یادگیری تقویتی عمیق نیز به عاملها کمک میکنند در محیطهای ساده یا پیچیده، ارزش انتخابها را تخمین بزنند و راهبردهای مناسبتری پیدا کنند.
بااینحال، یادگیری تقویتی بدون چالش نیست. نیاز به تجربه زیاد، طراحی پاداش، هزینه محاسباتی و تضمین ایمنی از مهمترین مسائلی هستند که پژوهشگران و مهندسان با آن روبهرو هستند.
شاید مهمترین نکته این باشد که یادگیری تقویتی نشان میدهد ماشین میتواند بدون دریافت پاسخ آماده برای تکتک موقعیتها، از تعامل با محیط و پیامد اقدامات خود برای بهبود تصمیمگیری استفاده کند؛ هرچند این توانایی به معنای یادگیری یا درک جهان به شیوه انسان نیست.
در قسمت بعدی چه میخوانیم؟
اگر ماشین میتواند با آزمون و خطا یاد بگیرد، پرسش بعدی این است که اساساً یک مدل هوش مصنوعی چگونه از دادههای خام به یک پیشبینی یا تصمیم میرسد؟
در قسمت بیستم: «هوش مصنوعی چگونه تصمیم میگیرد؟ از داده تا پیشبینی» به سراغ مفاهیمی مانند داده، ویژگی (Feature)، مدل، آموزش، استنتاج، پیشبینی و ارزیابی خطا میرویم تا ببینیم پشت یک تصمیم هوشمندانه چه فرآیندی جریان دارد.
هوش مصنوعی چگونه تصمیم میگیرد؟ از داده تا پیشبینی؛ قسمت بیستم
سؤالات متداول درباره یادگیری تقویتی (FAQ)
۱. یادگیری تقویتی چیست؟
یادگیری تقویتی روشی در یادگیری ماشین است که در آن یک عامل هوشمند با تعامل با محیط و دریافت پاداش، راهبرد خود را برای دستیابی به اهداف بهبود میدهد.
۲. تفاوت یادگیری تقویتی با یادگیری نظارتشده چیست؟
در یادگیری نظارتشده، مدل از دادههای دارای پاسخ مشخص یاد میگیرد؛ اما در یادگیری تقویتی، عامل با انجام اقدام و دریافت بازخورد از محیط، درباره انتخابهای خود یاد میگیرد.
۳. عامل هوشمند (Agent) در یادگیری تقویتی چیست؟
عامل هوشمند برنامه یا سامانهای است که وضعیت محیط را مشاهده میکند، اقدام انتخاب میکند و از بازخورد حاصل برای بهبود تصمیمهای بعدی استفاده میکند.
۴. پاداش در یادگیری تقویتی چه نقشی دارد؟
پاداش یک سیگنال عددی است که به عامل کمک میکند پیامد اقدامات خود را ارزیابی کند و سیاستی را یاد بگیرد که بازده مورد انتظار را بهبود میدهد.
۵. Q-Learning چیست؟
Q-Learning الگوریتمی در یادگیری تقویتی است که ارزش انجام اقدامهای مختلف را در وضعیتهای گوناگون تخمین میزند تا عامل بتواند تصمیمهای مناسبی بگیرد.
۶. یادگیری تقویتی عمیق چه تفاوتی با یادگیری تقویتی معمولی دارد؟
یادگیری تقویتی عمیق از شبکههای عصبی عمیق برای تخمین ارزش اقدامها یا یادگیری سیاست استفاده میکند و میتواند در مسائل دارای وضعیتهای پیچیده کاربرد داشته باشد.
۷. آیا یادگیری تقویتی در رباتیک کاربرد دارد؟
بله. یادگیری تقویتی در آموزش برخی رفتارهای رباتها، از جمله حرکت، کنترل و دستکاری اشیا، استفاده میشود؛ البته کاربردهای واقعی به آزمایش و ارزیابی ایمنی دقیق نیاز دارند.
۸. آیا یادگیری تقویتی همان یادگیری انسان از تجربه است؟
خیر. هر دو میتوانند از پیامد اقدامات و بازخورد استفاده کنند، اما یادگیری انسان علاوه بر این موارد، از زبان، مشاهده، حافظه، استدلال، احساسات و تعامل اجتماعی نیز تأثیر میپذیرد.
تحقیق و تدوین مهدی گمرکی