مجموعه در پایتون چیست؟ آموزش Set و عملیات آن
مجموعه در پایتون
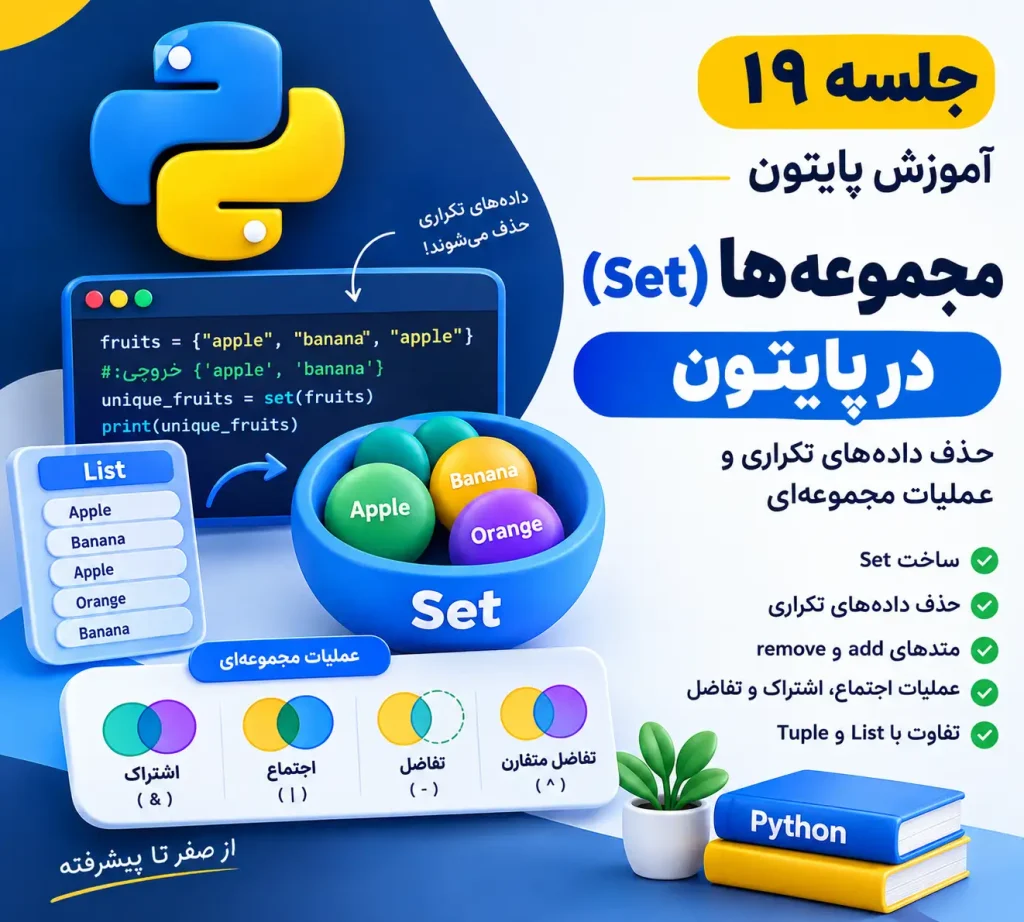
جلسه ۱۹ آموزش پایتون: مجموعهها (Set) در پایتون؛ حذف دادههای تکراری و عملیات مجموعهای
آموزش پایتون از صفر تا پیشرفته
add()، remove() و discard() آشنا میشویم. همچنین عملیات اجتماع، اشتراک و تفاضل مجموعهها را با مثالهای کاربردی یاد میگیریم. در پایان، با استفاده از Set در پروژههای واقعی و تفاوت آن با List و Tuple آشنا خواهیم شد.اگر جلسه قبل را مطالعه کردهاید، در این بخش از مسیر یادگیری پایتون، پس از آشنایی با تاپل در پایتون (Tuple) و تفاوت آن با لیست، سراغ یکی دیگر از ساختارهای مهم داده میرویم. این بار قرار است با مجموعهها (Set) آشنا شویم؛ ساختاری که به ما کمک میکند دادههای تکراری را حذف کنیم، مقادیر یکتا را نگهداری کنیم و عملیات ریاضی مانند اجتماع، اشتراک و تفاضل را روی دادهها انجام دهیم.
چرا به مجموعهها در پایتون نیاز داریم؟
تصور کنید یک فروشگاه اینترنتی دارید و اطلاعات محصولاتی را که مشتریان مشاهده کردهاند، ذخیره میکنید. ممکن است یک مشتری بارها یک محصول را مشاهده کند و نام آن چندین بار در اطلاعات ثبت شود.
برای مثال، فهرست زیر را در نظر بگیرید:
products = ["Laptop", "Mouse", "Laptop", "Keyboard", "Mouse"]در این فهرست، نام بعضی محصولات تکرار شده است. اگر بخواهیم فقط نام محصولات منحصربهفرد را داشته باشیم، باید راهی برای حذف دادههای تکراری پیدا کنیم.
یکی از روشها استفاده از حلقهها و شرطهاست؛ اما پایتون ساختار دادهای به نام Set دارد که این کار را بسیار سادهتر میکند.
products = {"Laptop", "Mouse", "Laptop", "Keyboard", "Mouse"}

print(products)
خروجی ممکن است به شکل زیر باشد:
{'Laptop', 'Mouse', 'Keyboard'}همانطور که مشاهده میکنید، مقادیر تکراری بهصورت خودکار در مجموعه نگهداری نمیشوند.
این ویژگی تنها کاربرد Set نیست. با استفاده از آن میتوانیم دادههای مشترک بین کاربران را پیدا کنیم، فهرستهای مختلف را با هم ترکیب کنیم و حتی الگوریتمهایی برای تحلیل داده طراحی کنیم.
مجموعه (Set) در پایتون چیست؟
مجموعه (Set) یک ساختار داده داخلی در پایتون است که برای نگهداری عناصر یکتا استفاده میشود.
سه ویژگی مهم Set عبارتاند از:
-
بدون عناصر تکراری: یک مقدار یکسان بهعنوان چند عنصر مستقل در Set نگهداری نمیشود.
-
بدون ترتیب مشخص: نمیتوان مانند List روی ترتیب عناصر Set حساب کرد.
-
قابل تغییر: میتوان عناصر را به مجموعه اضافه یا از آن حذف کرد.
برای مثال:
numbers = {10, 20, 30, 40}

print(numbers)
در این مثال یک مجموعه شامل چهار عدد ایجاد کردهایم.
نکته مهم این است که Set از اندیسگذاری مانند numbers[0] پشتیبانی نمیکند؛ زیرا عناصر آن دارای موقعیت ثابت و قابل اتکا مانند List نیستند.
همچنین عناصر یک Set باید از نوع دادههای قابل هش (Hashable) باشند. برای نمونه، عدد، رشته و Tupleهایی که عناصرشان قابل هش هستند، میتوانند عضو یک Set باشند؛ اما List و Dictionary را نمیتوان مستقیماً بهعنوان عضو Set قرار داد.
ساخت Set در پایتون
برای ساخت مجموعه در پایتون، معمولاً از آکولاد {} استفاده میکنیم.
fruits = {"Apple", "Banana", "Orange"}

print(fruits)
در این مثال، مجموعهای از سه نام میوه ایجاد کردهایم.
البته برخلاف Dictionary که با ساختار کلید و مقدار مشخص میشود، Set فقط شامل عناصر مستقل است.
ساخت مجموعه با اعداد
numbers = {10, 20, 30, 40, 50}

print(numbers)
ساخت مجموعه با انواع داده
data = {10, "Python", 3.14, True}

print(data)
پایتون اجازه میدهد انواع مختلف دادههای قابل هش را در یک مجموعه قرار دهیم.
البته بهتر است در برنامههای واقعی، مجموعههایی با هدف مشخص و عناصر هممعنا طراحی کنیم تا کد خواناتر باشد.
ساخت Set خالی
یکی از نکات مهم در ساخت Set، تفاوت آن با Dictionary خالی است.
اگر بنویسیم:
data = {}یک Dictionary خالی ایجاد میشود، نه Set.
برای ساخت مجموعه خالی باید از تابع set() استفاده کنیم:
data = set()

print(type(data))
خروجی:
<class 'set'>نکته مهم
برای ساخت Set خالی همیشه از set() استفاده کنید. آکولاد خالی {} در پایتون یک Dictionary ایجاد میکند.
حذف دادههای تکراری با Set
یکی از کاربردهای اصلی Set، حذف مقادیر تکراری از یک مجموعه داده است.
فرض کنید اطلاعات بازدید کاربران از محصولات یک فروشگاه را داریم:
visited_products = [
    "Laptop",
    "Mouse",
    "Laptop",
    "Keyboard",
    "Mouse",
    "Monitor"
]

unique_products = set(visited_products)

print(unique_products)
خروجی:
{'Laptop', 'Mouse', 'Keyboard', 'Monitor'}در این مثال، تابع set() فهرست را به مجموعه تبدیل کرده و مقادیر تکراری را حذف کرده است.
اگر بخواهیم نتیجه را دوباره به شکل List داشته باشیم، میتوانیم از تابع list() استفاده کنیم:
unique_products = list(set(visited_products))

print(unique_products)
اکنون خروجی یک List خواهد بود که عناصر تکراری ندارد؛ اما ترتیب عناصر آن ممکن است با ترتیب فهرست اولیه متفاوت باشد.
اگر حفظ ترتیب اولیه اهمیت داشته باشد، باید از روش دیگری استفاده کنیم؛ مثلاً:
unique_products = list(dict.fromkeys(visited_products))

print(unique_products)
خروجی:
['Laptop', 'Mouse', 'Keyboard', 'Monitor']در این روش، مقادیر تکراری حذف میشوند و ترتیب نخستین ظهور عناصر حفظ میشود.
افزودن عنصر به Set با متد add()
برای اضافه کردن یک عنصر جدید به مجموعه از متد add() استفاده میکنیم.
fruits = {"Apple", "Banana"}

fruits.add("Orange")

print(fruits)
خروجی شامل سه عنصر خواهد بود:
{'Apple', 'Banana', 'Orange'}اگر عنصری را که از قبل در مجموعه وجود دارد، دوباره اضافه کنیم، Set مقدار تکراری جدیدی ایجاد نمیکند.
fruits = {"Apple", "Banana"}

fruits.add("Apple")

print(len(fruits))
خروجی:
2بنابراین متد add() برای اضافه کردن یک عنصر به مجموعه کاربرد دارد، اما تعداد عناصر یکتا را افزایش میدهد، نه لزوماً تعداد دفعات فراخوانی آن را.
افزودن چند عنصر با update()
اگر بخواهیم چند عنصر را همزمان به Set اضافه کنیم، میتوانیم از متد update() استفاده کنیم.
fruits = {"Apple", "Banana"}

fruits.update(["Orange", "Mango", "Grape"])

print(fruits)
در این مثال، تمام عناصر قابل پیمایش ارسالشده به update() به مجموعه اضافه میشوند.
حتی اگر یکی از عناصر از قبل وجود داشته باشد، نسخه تکراری آن ایجاد نمیشود.
numbers = {10, 20}

numbers.update([20, 30, 40])

print(numbers)
مجموعه نهایی شامل اعداد ۱۰، ۲۰، ۳۰ و ۴۰ خواهد بود.
تفاوت اصلی این دو متد:
|
متد |
کاربرد |
|---|---|
|
|
افزودن یک عنصر |
|
|
افزودن عناصر یک یا چند مجموعه قابل پیمایش |
حذف عناصر از Set
در پایتون چند روش برای حذف عناصر یک مجموعه وجود دارد. مهمترین آنها remove()، discard()، pop() و clear() هستند.
متد remove()
متد remove() یک عنصر مشخص را از مجموعه حذف میکند.
fruits = {"Apple", "Banana", "Orange"}

fruits.remove("Banana")

print(fruits)
در این مثال، مقدار Banana حذف میشود.
اما اگر عنصر موردنظر در مجموعه وجود نداشته باشد، پایتون خطای KeyError ایجاد میکند.
fruits = {"Apple", "Orange"}

fruits.remove("Banana")
این کد با خطا روبهرو میشود؛ زیرا Banana در مجموعه وجود ندارد.
متد discard()
متد discard() نیز برای حذف یک عنصر استفاده میشود، اما تفاوت مهمی با remove() دارد.
اگر عنصر موردنظر در Set وجود نداشته باشد، discard() خطایی ایجاد نمیکند.
fruits = {"Apple", "Orange"}

fruits.discard("Banana")

print(fruits)
برنامه بدون خطا اجرا میشود و مجموعه تغییر نمیکند.
تفاوت remove و discard
-
remove()در صورت نبودن عنصر، خطایKeyErrorمیدهد. -
discard()در صورت نبودن عنصر، بدون خطا اجرا میشود.
زمانی که از وجود عنصر مطمئن نیستید، discard() معمولاً گزینه مناسبتری است.
متد pop()
متد pop() یک عنصر را از مجموعه حذف میکند و همان عنصر را برمیگرداند.
numbers = {10, 20, 30, 40}

removed = numbers.pop()

print(removed)
print(numbers)
از آنجا که Set ترتیب مشخصی ندارد، نباید فرض کنیم pop() حتماً کوچکترین، بزرگترین یا اولین عنصر را حذف میکند.
اگر مجموعه خالی باشد، فراخوانی pop() باعث خطای KeyError میشود.
متد clear()
اگر بخواهیم تمام عناصر مجموعه را حذف کنیم، از clear() استفاده میکنیم.
numbers = {10, 20, 30}

numbers.clear()

print(numbers)
خروجی:
set()متد clear() خود مجموعه را خالی میکند و متغیر همچنان به یک Set خالی اشاره خواهد کرد.
عملیات مجموعهای در پایتون
یکی از مهمترین قابلیتهای Set، امکان انجام عملیات ریاضی روی مجموعههاست. پایتون ابزارهایی در اختیار ما قرار میدهد که با استفاده از آنها میتوانیم عناصر مشترک، عناصر متفاوت و ترکیب چند مجموعه را به دست آوریم.
برای درک بهتر این موضوع، دو مجموعه از کاربران یک وبسایت را در نظر بگیرید:
group_a = {"Ali", "Sara", "Reza", "Mina"}
group_b = {"Sara", "Mina", "Nima", "Amir"}
در این مثال، هر مجموعه شامل نام کاربرانی است که در یک گروه مشخص عضو هستند.
- نمایش دو مجموعه و عناصر مشترک
فقط گروه A
-
فقط گروه B
مشترک
۱. اجتماع مجموعهها (Union)
اجتماع دو مجموعه، تمام عناصری را شامل میشود که حداقل در یکی از آن دو مجموعه وجود دارند. عناصر مشترک فقط یک بار در نتیجه ظاهر میشوند.
برای انجام اجتماع میتوانیم از عملگر | یا متد union() استفاده کنیم.
group_a = {"Ali", "Sara", "Reza", "Mina"}
group_b = {"Sara", "Mina", "Nima", "Amir"}

result = group_a.union(group_b)

print(result)
نتیجه شامل شش کاربر یکتا خواهد بود.
روش دوم:
result = group_a | group_bهر دو روش نتیجه یکسانی دارند.
کاربرد واقعی: فرض کنید میخواهید فهرست تمام کاربرانی را به دست آورید که حداقل در یکی از دو گروه آموزشی عضو هستند. اجتماع مجموعهها این کار را انجام میدهد.
۲. اشتراک مجموعهها (Intersection)
اشتراک دو مجموعه، عناصری را برمیگرداند که در هر دو مجموعه وجود دارند.
برای این کار از عملگر & یا متد intersection() استفاده میکنیم.
group_a = {"Ali", "Sara", "Reza", "Mina"}
group_b = {"Sara", "Mina", "Nima", "Amir"}

result = group_a.intersection(group_b)

print(result)
خروجی:
{'Sara', 'Mina'}روش دیگر:
result = group_a & group_bکاربرد واقعی: اگر بخواهید بدانید چه کاربرانی همزمان در دو دوره آموزشی ثبتنام کردهاند، اشتراک دو مجموعه میتواند پاسخ این سؤال را بدهد.
۳. تفاضل مجموعهها (Difference)
تفاضل دو مجموعه، عناصری را برمیگرداند که در مجموعه اول وجود دارند، اما در مجموعه دوم نیستند.
برای انجام این عملیات از - یا متد difference() استفاده میکنیم.
group_a = {"Ali", "Sara", "Reza", "Mina"}
group_b = {"Sara", "Mina", "Nima", "Amir"}

result = group_a.difference(group_b)

print(result)
خروجی:
{'Ali', 'Reza'}در این مثال، کاربرانی نمایش داده میشوند که در گروه A حضور دارند، اما عضو گروه B نیستند.
اگر ترتیب مجموعهها را تغییر دهیم، نتیجه نیز تغییر میکند:
result = group_b - group_a

print(result)
خروجی:
{'Nima', 'Amir'}نکته: تفاضل مجموعهها جابهجاییپذیر نیست؛ یعنی A - B لزوماً با B - A برابر نیست.
۴. تفاضل متقارن (Symmetric Difference)
گاهی میخواهیم عناصری را پیدا کنیم که فقط در یکی از دو مجموعه وجود دارند، نه در هر دو.
این عملیات تفاضل متقارن نام دارد و با عملگر ^ یا متد symmetric_difference() انجام میشود.
group_a = {"Ali", "Sara", "Reza", "Mina"}
group_b = {"Sara", "Mina", "Nima", "Amir"}

result = group_a.symmetric_difference(group_b)

print(result)
خروجی شامل کاربران زیر خواهد بود:
{'Ali', 'Reza', 'Nima', 'Amir'}در این عملیات، کاربران مشترک یعنی Sara و Mina حذف میشوند و فقط اعضای غیرمشترک باقی میمانند.
خلاصه عملیات مجموعهای
|
عملیات |
عملگر |
کاربرد |
|---|---|---|
|
اجتماع |
|
تمام عناصر یکتا |
|
اشتراک |
|
عناصر مشترک |
|
تفاضل |
|
عناصر موجود فقط در A |
|
تفاضل متقارن |
|
عناصر غیرمشترک |
بررسی رابطه بین مجموعهها
علاوه بر عملیات ریاضی، در پایتون میتوانیم رابطه بین دو Set را نیز بررسی کنیم.
زیرمجموعه (Subset)
اگر تمام عناصر یک مجموعه در مجموعه دیگری وجود داشته باشند، مجموعه اول زیرمجموعه مجموعه دوم است.
برای بررسی این رابطه از issubset() یا عملگر <= استفاده میکنیم.
a = {10, 20}
b = {10, 20, 30, 40}

print(a.issubset(b))
خروجی:
Trueچون تمام عناصر a در b وجود دارند.
ابرمجموعه (Superset)
اگر تمام عناصر یک مجموعه در مجموعه دیگر وجود داشته باشند، مجموعه بزرگتر از نظر عضویت، ابرمجموعه مجموعه کوچکتر است.
برای بررسی این موضوع از issuperset() یا >= استفاده میکنیم.
a = {10, 20}
b = {10, 20, 30, 40}

print(b.issuperset(a))
خروجی:
Trueمجموعههای جدا از هم (Disjoint)
اگر دو مجموعه هیچ عنصر مشترکی نداشته باشند، به آنها مجموعههای جدا از هم گفته میشود.
برای بررسی این رابطه از isdisjoint() استفاده میکنیم.
a = {10, 20, 30}
b = {40, 50, 60}

print(a.isdisjoint(b))
خروجی:
Trueاما اگر حتی یک عنصر مشترک داشته باشند، نتیجه False خواهد بود.
a = {10, 20, 30}
b = {30, 40, 50}

print(a.isdisjoint(b))
خروجی:
Falseپیمایش Set با حلقه for
با وجود اینکه Set از اندیسگذاری پشتیبانی نمیکند، میتوانیم با استفاده از حلقه for تمام عناصر آن را پیمایش کنیم.
fruits = {"Apple", "Banana", "Orange"}

for fruit in fruits:
    print(fruit)
در این مثال، نام تمام میوهها نمایش داده میشود؛ اما ترتیب نمایش آنها تضمینشده نیست.
اگر بخواهیم عناصر را به ترتیب مشخصی نمایش دهیم، میتوانیم از sorted() استفاده کنیم:
fruits = {"Orange", "Apple", "Banana"}

for fruit in sorted(fruits):
    print(fruit)
خروجی:
Apple
Banana
Orange
دقت کنید که sorted() یک فهرست مرتبشده برمیگرداند و خود Set را تغییر نمیدهد.
مثال کاربردی؛ شناسایی کاربران مشترک یک وبسایت
فرض کنید یک وبسایت آموزشی داریم که کاربران آن در دو دوره پایتون و هوش مصنوعی ثبتنام کردهاند.
python_students = {
    "Ali",
    "Sara",
    "Reza",
    "Mina"
}

ai_students = {
    "Sara",
    "Mina",
    "Nima",
    "Amir"
}
حالا میخواهیم چند گزارش مختلف تهیه کنیم.
- تمام دانشجویان هر دو دوره:
all_students = python_students | ai_students

print(all_students)- دانشجویانی که در هر دو دوره ثبتنام کردهاند:
both_courses = python_students & ai_students

print(both_courses)- دانشجویانی که فقط در دوره پایتون هستند:
only_python = python_students - ai_students

print(only_python)- دانشجویانی که فقط در یکی از دو دوره حضور دارند:
one_course = python_students ^ ai_students

print(one_course)
با چند عمل ساده میتوان گزارشهایی تهیه کرد که در یک سامانه ثبتنام یا تحلیل رفتار کاربران کاربرد دارند.
تفاوت Set با List و Tuple
تا این مرحله از دوره با سه ساختار داده مهم پایتون آشنا شدهایم: List، Tuple و Set. هر سه میتوانند چند مقدار را نگهداری کنند، اما ویژگیها و کاربردهای متفاوتی دارند.
|
ویژگی |
List |
Tuple |
Set |
|---|---|---|---|
|
نماد متداول |
|
|
|
|
ترتیب |
حفظ میشود |
حفظ میشود |
تضمین نمیشود |
|
اندیسگذاری |
دارد |
دارد |
ندارد |
|
عناصر تکراری |
مجاز |
مجاز |
نگهداری نمیشوند |
|
قابلیت تغییر |
دارد |
ندارد |
دارد |
|
افزودن عنصر |
|
ندارد |
|
|
حذف عنصر |
|
ندارد |
|
|
کاربرد مهم |
دادههای مرتب و قابل تغییر |
دادههای مرتب و تغییرناپذیر |
دادههای یکتا و عملیات مجموعهای |
برای مثال، اگر بخواهیم فهرست سفارشهای مشتری را به همان ترتیب ثبتشده نگهداری کنیم، List گزینه مناسبی است.
اگر بخواهیم اطلاعات ثابتی مانند مختصات یک نقطه را ذخیره کنیم، Tuple میتواند مناسب باشد.
اما اگر هدف ما نگهداری شناسههای یکتا، حذف تکراریها یا پیدا کردن دادههای مشترک باشد، Set انتخاب کاربردیتری است.
آیا Set همیشه سریعتر از List است؟
یکی از دلایل استفاده از Set، کارایی آن در بررسی عضویت است.
برای مثال، اگر بخواهیم بررسی کنیم که یک شناسه در میان دادهها وجود دارد یا خیر، Set در حالت معمول برای عملیات عضویت بهطور متوسط زمان نزدیک به ثابت دارد؛ در حالی که بررسی یک List معمولاً با افزایش تعداد عناصر، زمان بیشتری میگیرد.
با این حال، کارایی واقعی به اندازه دادهها، نوع عملیات و شرایط اجرای برنامه وابسته است. بنابراین نباید تصور کنیم Set برای تمام کاربردها از List سریعتر است.
همچنین Set حافظه مصرف میکند و برای دادههایی که به ترتیب و اندیس نیاز دارند، جایگزین مناسبی برای List نیست.
خطاهای رایج هنگام کار با Set در پایتون
هنگام استفاده از مجموعهها، برخی اشتباهات میان برنامهنویسان مبتدی رایج است. شناخت این خطاها کمک میکند کدهای دقیقتر و قابلاعتمادتری بنویسیم.
۱. تلاش برای دسترسی با اندیس
کد زیر صحیح نیست:
numbers = {10, 20, 30}

print(numbers[0])
Set از اندیسگذاری پشتیبانی نمیکند و اجرای این کد باعث خطای TypeError میشود.
برای دسترسی به عناصر، میتوانیم از حلقه for استفاده کنیم.
۲. ساخت Set خالی با آکولاد
numbers = {}این دستور یک Dictionary خالی میسازد، نه Set.
روش صحیح:
numbers = set()۳. استفاده از عناصر تغییرپذیر داخل Set
کد زیر خطا ایجاد میکند:
data = {[10, 20], [30, 40]}زیرا List قابل هش نیست و نمیتواند عضو Set باشد.
اما میتوانیم از Tupleهای قابل هش استفاده کنیم:
data = {(10, 20), (30, 40)}۴. استفاده از remove برای عنصری که وجود ندارد
numbers = {10, 20, 30}

numbers.remove(50)
چون عدد ۵۰ در مجموعه وجود ندارد، پایتون خطای KeyError ایجاد میکند.
اگر احتمال میدهیم عنصر وجود نداشته باشد، میتوانیم از discard() استفاده کنیم.
۵. فرض کردن ترتیب ثابت عناصر
numbers = {30, 10, 20}

print(numbers)
نباید انتظار داشته باشیم عناصر حتماً به ترتیب واردشده نمایش داده شوند. اگر به ترتیب مشخصی نیاز داریم، از sorted() استفاده میکنیم.
تمرینهای جلسه ۱۹
برای تسلط بیشتر بر مجموعهها، تمرینهای زیر را انجام دهید. بهتر است ابتدا خودتان کدها را بنویسید و سپس نتیجه را بررسی کنید.
تمرینهای ساده
تمرین ۱؛ ساخت مجموعه
یک Set شامل پنج عدد دلخواه بسازید و تمام عناصر آن را با حلقه for نمایش دهید.
تمرین ۲؛ حذف تکراریها
یک List شامل نام چند میوه ایجاد کنید که حداقل دو مقدار تکراری داشته باشد. سپس با استفاده از set() عناصر تکراری را حذف کنید.
تمرین ۳؛ افزودن و حذف
یک مجموعه از نام سه محصول بسازید. یک محصول با add() اضافه کنید و با discard() یک محصول دیگر را حذف کنید.
تمرین ۴؛ اشتراک دو مجموعه
دو مجموعه از اعداد بسازید و با استفاده از عملگر & اعداد مشترک آنها را پیدا کنید.
تمرین ۵؛ اجتماع و تفاضل
دو مجموعه از نام کاربران بسازید و تمام کاربران یکتا و همچنین کاربرانی را که فقط در مجموعه اول هستند، نمایش دهید.
تمرین ۶؛ تشخیص عضویت
یک مجموعه از شناسههای محصولات بسازید و با استفاده از in بررسی کنید شناسه مشخصی در آن وجود دارد یا خیر.
تمرین چالشی؛ تحلیل ثبتنام دورهها
دو Set از کاربران ثبتنامشده در دو دوره آموزشی ایجاد کنید. تمام کاربران، کاربران مشترک، کاربران اختصاصی هر دوره و کاربرانی را که فقط در یکی از دو دوره حضور دارند، گزارش کنید.
جمعبندی جلسه ۱۹؛ مجموعهها در پایتون
در این جلسه با Set و ویژگیهای مهم آن آشنا شدیم. یاد گرفتیم که مجموعهها برای نگهداری عناصر یکتا طراحی شدهاند و به دلیل پشتیبانی از عملیات مجموعهای، در بسیاری از برنامهها کاربرد دارند.
مهمترین نکات این جلسه:
-
Set ساختاری برای نگهداری عناصر یکتا است.
-
عناصر Set ترتیب مشخص و اندیس قابل استفاده ندارند.
-
با
set()میتوان یک مجموعه خالی ساخت. -
متد
add()برای افزودن یک عنصر وupdate()برای افزودن چند عنصر استفاده میشود. -
متدهای
remove()وdiscard()برای حذف عناصر کاربرد دارند. -
با
union()یا|میتوان اجتماع مجموعهها را به دست آورد. -
با
intersection()یا&میتوان عناصر مشترک را پیدا کرد. -
با
difference()یا-میتوان عناصر موجود در یک مجموعه و غایب در مجموعه دیگر را به دست آورد. -
با
symmetric_difference()یا^میتوان عناصر غیرمشترک را پیدا کرد. -
متدهای
issubset()،issuperset()وisdisjoint()برای بررسی روابط مجموعهها استفاده میشوند. -
Set در بررسی عضویت و حذف دادههای تکراری بسیار کاربردی است.
نکته کلیدی این جلسه
اگر به دادههای یکتا نیاز دارید یا میخواهید عناصر مشترک و متفاوت چند مجموعه را پیدا کنید، Set یکی از ابزارهای اصلی شما در پایتون خواهد بود.
جلسه بعد؛ دیکشنری در پایتون (Dictionary)
دیکشنری در پایتون؛ ذخیره اطلاعات با کلید و مقدار
در جلسه بعد با یکی از کاربردیترین ساختارهای داده پایتون، یعنی Dictionary، آشنا میشویم. دیکشنری به ما امکان میدهد اطلاعات را بهصورت جفتهای کلید و مقدار (Key-Value) ذخیره کنیم و بهجای استفاده از اندیس، با کلید مناسب به دادهها دسترسی داشته باشیم.
در جلسه ۲۰ یاد میگیریم:
-
دیکشنری چیست و چگونه ساخته میشود؟
-
مفهوم Key و Value چیست؟
-
چگونه به دادهها دسترسی پیدا کنیم؟
-
چگونه مقادیر را تغییر دهیم؟
-
چگونه اطلاعات جدید اضافه یا حذف کنیم؟
-
متدهای
keys()،values()،items()وget()چه کاربردی دارند؟ -
چگونه با حلقه
forیک Dictionary را پیمایش کنیم؟
لینک داخلی به جلسه بعد: برای ادامه مسیر، آموزش [دیکشنری در پایتون و نحوه کار با کلید و مقدار (Dictionary)] را در جلسه ۲۰ دنبال کنید.
سؤالات متداول درباره Set در پایتون (FAQ)
۱. Set در پایتون چیست؟
Set یک ساختار داده برای نگهداری عناصر یکتا و بدون ترتیب مشخص است. این ساختار برای حذف دادههای تکراری و انجام عملیات مجموعهای کاربرد دارد.
۲. چگونه در پایتون یک Set خالی بسازیم؟
برای ساخت یک مجموعه خالی باید از set() استفاده کنیم. آکولاد خالی {} در پایتون یک Dictionary ایجاد میکند.
۳. چگونه دادههای تکراری را در پایتون حذف کنیم؟
با تبدیل یک مجموعه داده مانند List به Set میتوان مقادیر تکراری را حذف کرد:
numbers = [10, 20, 10, 30]
unique_numbers = set(numbers)
۴. تفاوت List و Set در پایتون چیست؟
List ترتیب عناصر را حفظ میکند، از اندیسگذاری پشتیبانی میکند و اجازه نگهداری مقادیر تکراری را میدهد؛ اما Set عناصر تکراری را نگهداری نمیکند و اندیسگذاری ندارد.
۵. تفاوت متدهای remove و discard چیست؟
هر دو برای حذف عنصر استفاده میشوند، اما remove() در صورت نبودن عنصر خطای KeyError ایجاد میکند، در حالی که discard() بدون خطا اجرا میشود.
۶. چگونه دو Set را در پایتون با هم ترکیب کنیم؟
با استفاده از عملگر | یا متد union() میتوان اجتماع دو مجموعه را به دست آورد. نتیجه شامل تمام عناصر یکتا از هر دو مجموعه است.
۷. چگونه عناصر مشترک دو مجموعه را پیدا کنیم؟
با استفاده از عملگر & یا متد intersection() میتوان عناصری را که در هر دو مجموعه حضور دارند، پیدا کرد.
۸. آیا Set در پایتون ترتیب دارد؟
خیر، Set ترتیب مشخص و قابل اتکایی برای پیمایش عناصر ارائه نمیدهد. اگر به ترتیب مشخص نیاز دارید، میتوانید از sorted() استفاده کنید.
۹. آیا میتوان List را داخل Set قرار داد؟
خیر، List قابل هش نیست و نمیتواند عضو مستقیم Set باشد. اما میتوان در شرایط مناسب از Tupleهای قابل هش بهعنوان عناصر Set استفاده کرد.
۱۰. مهمترین کاربرد Set در پایتون چیست؟
حذف دادههای تکراری، بررسی سریع عضویت و انجام عملیات اجتماع، اشتراک، تفاضل و تفاضل متقارن از مهمترین کاربردهای Set هستند.
پیشنهاد ساختاری: در صورت استفاده از FAQ Schema، پرسشها و پاسخهای ساختاریافته باید با محتوای قابل مشاهده همین بخش از مقاله مطابقت داشته باشند.
مسیر یادگیری پایتون را ادامه دهید
در این جلسه با مجموعهها آشنا شدیم و یاد گرفتیم چطور دادههای یکتا را مدیریت کنیم. گام بعدی، یادگیری دیکشنری است؛ ساختاری که برای نگهداری دادههای مرتبط با کلید و مقدار در پروژههای واقعی بسیار مهم است.
جلسه ۲۰: دیکشنری در پایتون (Dictionary)
از مجموعههای یکتا به ساختارهای کلید و مقدار بروید و مدیریت اطلاعات را حرفهایتر یاد بگیرید.
تحقیق و تدوین مهدی گمرکی